AI知识库的下半场:从查资料到撑起一场主题讨论
去年冬天,一家设计院的暖通专业开了一次方案评审会。议题是某三甲医院手术部的净化空调方案选型:一拖多还是独立冷源,一次回风还是二次回风。会开了两个半小时,六个人各说各的,中途有人翻出三年前的规范条文,有人记得某个项目出过冷凝水问题但记不清是哪个项目,还有人提到厂家样本里的一个参数但拿不出原文。会议纪要最后写了一句"方案待定,下次再议"。第二次会议,同样的人,同样的争论,只是又多了两个小时。散会时总工说了一句话,很扎心:"我们不是在讨论,我们是在各自回忆。"
一、检索型知识库解决不了的,是"分歧"
大多数企业建AI知识库系统,目标非常朴素:让员工能查到资料。这条路上,技术已经相对成熟——文档入库、切分、向量化、检索、生成答案,一个中等规模的系统几个月能上线。但上线之后,很多企业会发现一个现象:访问量在前三个月冲高,然后缓慢回落,最后稳定在一个不温不火的水平。原因不是检索不准,而是检索解决的是"我知道要查什么"的场景,而知识型工作里最难的部分恰恰是"我不知道该问什么"和"我们几个人看法不一样"。
这两件事本质上是讨论,不是检索。讨论有几个检索系统接不住的特征:一是多轮,一个问题会引出下一个问题,问题的方向在讨论过程中才浮现;二是多主体,不同专业、不同岗位带着不同的知识背景发言,同一条规范在结构工程师和施工方眼里结论可能相反;三是需要证据,一句"我记得好像不行"在讨论里没有说服力,必须落到具体条文、具体项目、具体数据上;四是有产出,讨论的目的是形成决策,而不是各自表达完就散。传统知识库把知识当成静态库存,讨论场景要求知识是"被调用的"——讨论到哪一步,相关知识就出现在哪一步。这是大模型知识库RAG能往前再走一步的地方。
二、主题讨论空间:知识库的第三种用法
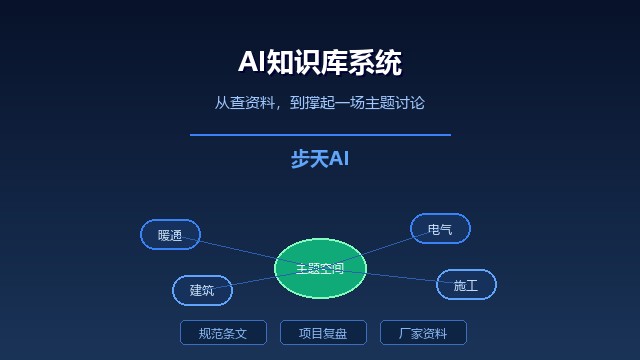
所谓"扩展应用为主题讨论",最直观的形态是:知识库不再只有一个搜索框,而是有一批"主题空间"。每个主题空间围绕一个业务议题建立,比如"医院洁净手术部空调选型"、"既有建筑改造的结构加固方案"、"装配式建筑成本控制"。空间里同时装三类东西:一是知识资产——相关规范、标准图集、过往项目案例、厂家资料;二是讨论线索——围绕这个主题的历史讨论、评审记录、争议点清单;三是参与者——谁在这个主题上有经验、谁参与过哪个项目。
这个形态和传统"文档目录"的区别在于:目录是按文件组织的,主题空间是按问题组织的。同一个文件可能同时属于三个主题空间,因为它在三个议题里都有价值。员工进入空间不是"找文件",而是"进入一个正在进行的话题"——看到上次讨论到哪、还有哪些分歧没解决、有哪些新资料进来。知识库从"档案室"变成了"议事厅",这是使用逻辑上的根本转变。
三、讨论过程中的知识调用:让证据自动浮上来
主题空间最见功力的地方,是讨论进行时的知识调用。举一个具体场景:讨论中有人打出一句"二次回风在手术室用得少,因为湿度控制难"。系统在这一刻做三件事。第一,把这句话当作查询,在这批主题资产里检索——找到《医院洁净手术部建筑技术规范》里关于相对湿度的条文、两年前某个项目因二次回风除湿不足导致术后感染投诉的复盘报告、以及一份厂家技术白皮书里对二次回风适用条件的说明。第二,把检索结果以"证据卡片"的形式贴在发言下方,每张卡片带原文摘录、出处页码、项目编号,讨论参与者点开就能核到原文,不用再互相要资料。第三,标注证据的方向——是支持、是反驳、还是补充条件,让讨论里的分歧变得清晰:分歧不是"谁嗓门大",而是"两条证据之间的冲突"。
这件事听起来简单,工程上要过几道关。一是检索的语境化:一句口语化的发言检索不到规范条文,需要先做术语归一——"湿度难控"要映射到"相对湿度控制精度"、"除湿能力"这类规范用语。二是专业性排序:同一个问题会召回几十条资料,哪些该排前面?答案不是语义相似度,而是"能不能支撑判断"——规范条文和同类项目复盘优先级高于通用介绍文章。三是引用可信度:内部项目复盘和外部厂家资料的可信度不同,证据卡片要标明性质,不能混在一起当成同级证据。这套能力靠的不是更大的模型,而是智能文档检索系统的字段索引、混合召回和元数据标注。
四、讨论结束后:把口头经验变成可检索的知识
主题讨论真正的价值,在散会之后。传统会议的场景是:散会,纪要归档,争论的过程消失,只留一句"方案待定"。半年后换一批人再议同一个议题,一切从头来过。主题空间要做的,是把讨论本身沉淀成知识资产。具体做法有三层。
第一层是结构化讨论记录:不是把聊天记录原样存下来,而是抽取成"议题—观点—证据—结论"的结构。哪几个议题、每个议题下有几种观点、每种观点引用了哪些证据、最后形成了什么结论、哪些分歧被搁置。这层结构让讨论可被再次引用,而不是埋在几百条消息里。
第二层是分歧清单:把没有达成一致的争议点单独列出来,标注争议双方的核心论据和缺失的信息。这份清单是下一次讨论的起点,也是最有价值的部分——它告诉后来者"这个问题争到哪里了、还缺什么证据才能下结论",避免重复劳动。
第三层是决策留痕:最终采纳了什么方案、依据哪几条证据、谁拍的板、当时排除了哪些选项及理由。这一层在工程、医疗、金融这些强监管行业尤其重要——几年后追责或者复用时,"当时为什么这么定"比"定了什么"更关键。步天AI在主题空间里把这层结构固化下来,讨论记录、证据引用、分歧清单和决策结论一起归档,并且全部锚定到原文出处,支持私有化部署与细粒度权限管控。
五、为什么"主题"比"部门"和"项目"更适合组织知识
企业组织知识常用的两个维度是部门和项目。按部门分,问题在于跨部门的知识无处安放——医院手术部空调选型同时涉及暖通、建筑、电气、医疗工艺,放在哪个部门都不完整。按项目分,问题在于项目结束后知识就沉底了,下一个项目很少有人回头翻上一个项目的资料。主题维度补上了这个缺口:主题是跨部门、跨项目的,一个主题空间可以吸收多个部门、多个项目的相关资产,只要它们回答的是同一类问题。
这个设计还有一个隐性收益:它让"谁懂什么"变得可见。传统组织里,专家经验藏在个人脑子里,新人不知道找谁问;主题空间里,参与过多次讨论、贡献过被采纳观点的人,自然浮现为这个主题的"活跃贡献者"。这不是绩效评价,而是知识地图——下次遇到同类问题,知道该拉谁进讨论。很多企业做知识管理失败,不是资料不够,而是"找不到人",主题空间同时解决了"找资料"和"找人"两件事。
六、三个必须提前想清楚的坑
第一个坑是主题膨胀。一开始热情高涨,建了两百个主题空间,结果每个空间里只有三份文档、一次讨论,全部变成空壳。稳妥做法是自上而下圈定二十个以内的高频议题,每个议题必须有明确的负责人和至少一个真实待解决的问题,跑起来再逐步扩展。主题空间不是越多越好,活跃度比数量重要。
第二个坑是心理安全。讨论要真实,就不能让发言和考核挂钩。如果员工知道自己说的每句话都被记录、被上级看到、可能成为年底评价依据,讨论就会变成表态。工程上的应对是分级可见:讨论内容在空间内可见,但个人发言统计不进入任何考核体系,敏感议题支持匿名或实名仅对主持人可见。这条不是技术问题,是制度设计问题,但决定了主题空间是活的还是死的。
第三个坑是过度自动化。有的企业希望AI直接给出讨论结论,这很危险。主题讨论的价值恰恰在于不同专业的碰撞,AI的角色是提供证据、整理观点、识别分歧,而不是替人下结论。系统可以写"目前有两种观点,A观点有三条证据支持,B观点缺一项现场数据",但不能写"建议采用A方案"。一旦越界,讨论就失去了意义,参与者也会迅速退出。
七、落地路径:从一个真实的争议议题开始
不建议把主题讨论做成一个全公司推广的项目,那大概率会变成一次性的活动。更有效的做法是:找一件当下真的悬而未决、且涉及多个专业的事——比如某个正在做的项目里,一个反复讨论没定下来的技术选型。围绕它建第一个主题空间,把相关资料全部归集进去,把历史讨论记录整理成议题和分歧清单,然后组织一次真正带着问题来的讨论,讨论中让系统实时提供证据,讨论后把结构和结论沉淀下来。
跑完这一个闭环,再判断要不要推广。判断标准很具体:这次讨论有没有比上一次更快形成结论?分歧清单有没有让下一次讨论少走弯路?参与者有没有主动回头调用这个空间?三个问题里有两个是肯定的,说明这条路走得通。反过来,如果讨论依然靠嗓门、资料依然靠人找、结论依然靠总工拍板,那就说明知识库扩展成主题讨论,还只是给它换了个名字。
补充阅读:AI知识库系统为何遍地开花;企业知识库管理系统的选型要点
回到那家设计院。第二次评审会之后,他们把"医院洁净手术部空调选型"做成了第一个主题空间。第三次开会时,讨论到"二次回风湿度控制"这一条,系统把规范条文、两年前的投诉复盘、厂家白皮书三张证据卡片同时贴了出来,争论在二十分钟内收敛。散会时那位总工没有再说"我们在各自回忆",他说的是:"今天总算是在同一份材料上吵架了。"这句话,大概就是知识库从检索走向讨论的全部意义。
延伸阅读:
AI知识库系统答不准:问题多半出在检索链路
大模型知识库RAG的落地路径与常见误区
AI知识库现有内容如何生成报告
上一篇:设备点检靠手写?AI报告生成工具让产线报告自动出 下一篇:没有了.